洗掉 AI 味?我實測後,神話破滅
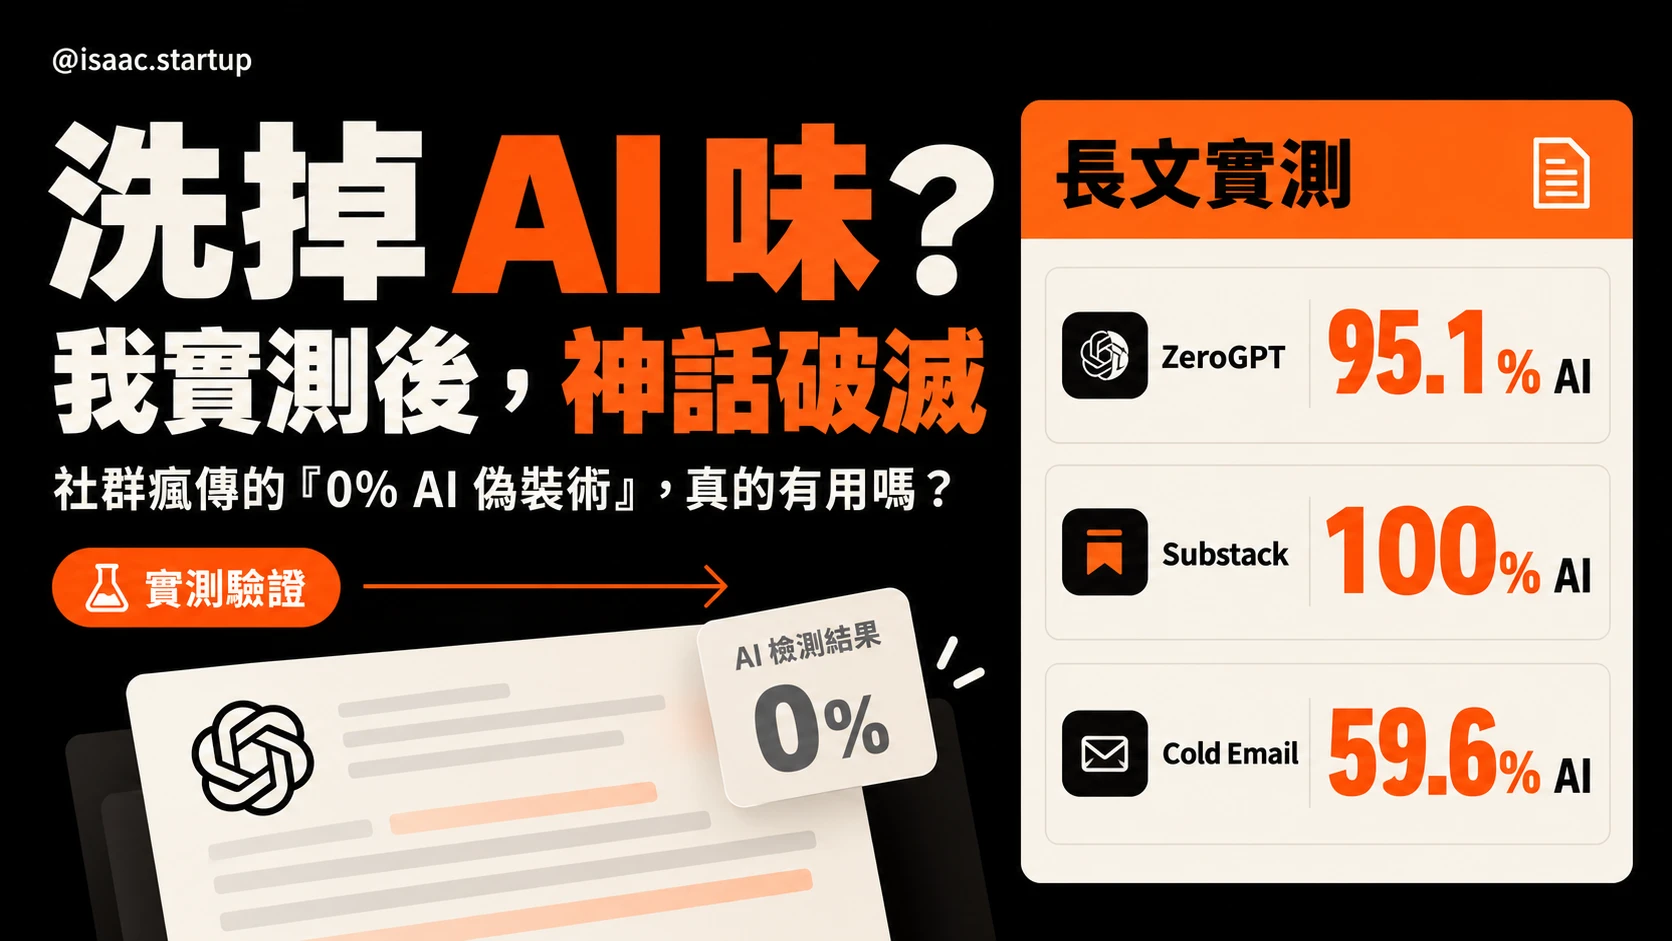
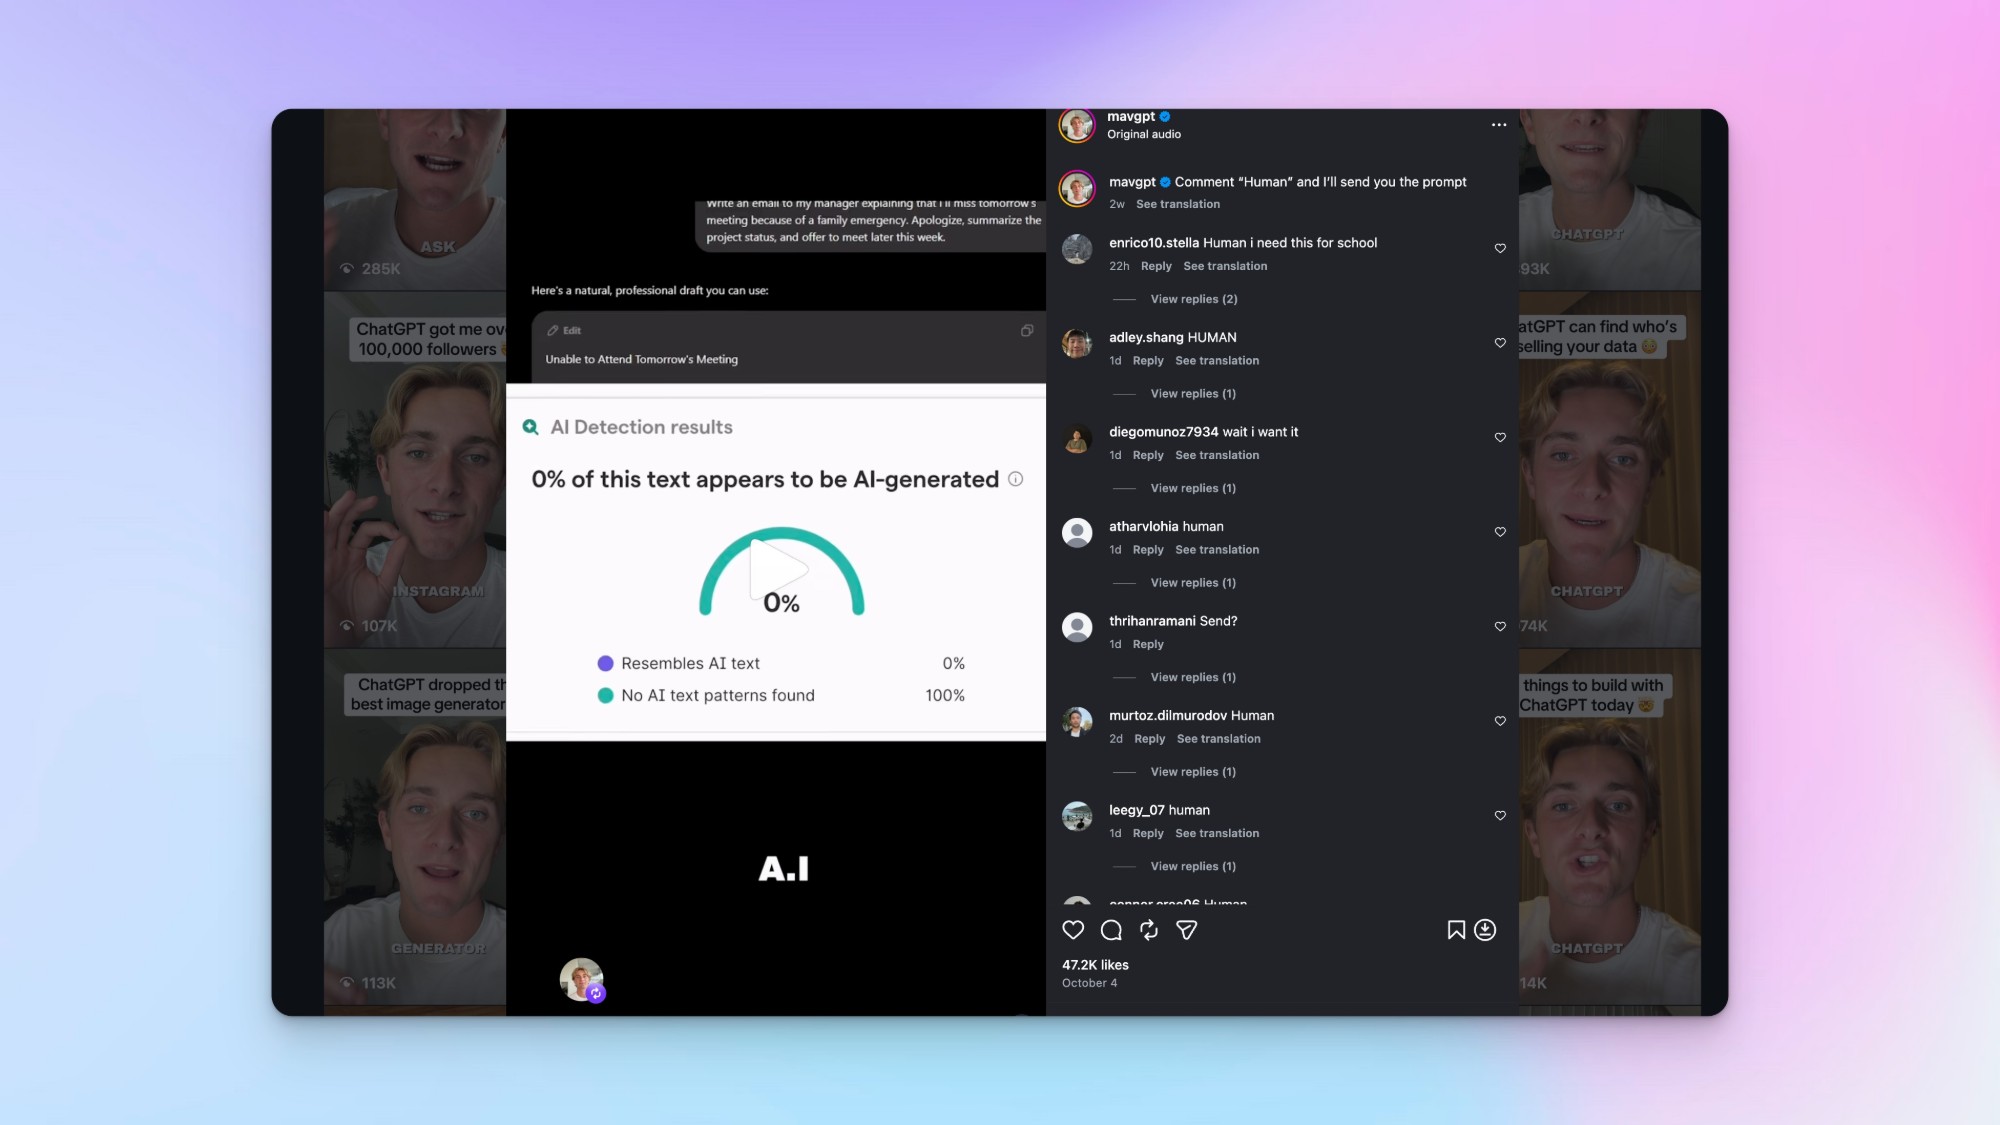
最近在 Instagram 有一段超過 140 萬觀看的短影音在 AI 圈瘋傳。
原影片的作者是我常看的一位 AI 分享者 @mavgpt。
原文內容:
網站:ChatGPT Humanizer Guide
IG:https://www.instagram.com/reel/DeAlplDKe35/
影片中,他分享了只要按照他的「三步驟」就能徹底洗掉 ChatGPT 的「AI 味」,甚至讓檢測器測出 0% AI Generated(純人類撰寫)的驚人成績。
這套方法看起來既聰明又極具說服力,步驟如下:
- 去維基百科抓出所有 AI 寫作特徵
- 讓 ChatGPT 把特徵轉換成「不可打破的寫作禁令」
- 最後存入客製化指令(Custom Instructions)
身為一名每天與 AI 工具打交道的實戰派,我向來不相信「完美截圖」。
於是,我打開了 ChatGPT 與 Grok,嚴格按照這份指南的步驟一步步實測,並用主流的 ZeroGPT 與 Substack AI Scanner(基於 Pangram)進行雙重驗證。
實測的結果打破了 100% 的聲明,也意外揭露了 AI 檢測器鮮為人知的運作邏輯。
社群瘋傳的「0% 偽裝術」是怎麼運作的?
這套由 @mavgpt 分享的方法,核心邏輯非常直觀:「AI 檢測器不讀語意,它們只抓統計模式(Patterns)。」
維基百科上有一篇專門記錄 AI 寫作痕跡的頁面:Wikipedia: Signs of AI writing。
裡面整理了大量大型語言模型(LLM)的通病,例如:
- 內容灌水:喜歡用「Serves as a testament to…(這證明了……)」、「Pivotal moment(關鍵轉折點)」。
- 死板的語言模式:泛濫的「Delve(深入探討)」、「Crucial(至關重要)」、「Landscape(全貌/格局)」。
- 句型對稱病:動不動就「Not only… but also…(不僅……而且……)」、硬湊「三段論(Rule of three)」。
- 符號與格式:泛濫的破折號(Em dashes —)、每個小標都加粗、結尾千篇一律的「The future looks bright」。
教學的主張是:既然特徵都公開在維基百科上,那我們直接套用,叫 AI 改寫。
操作步驟:
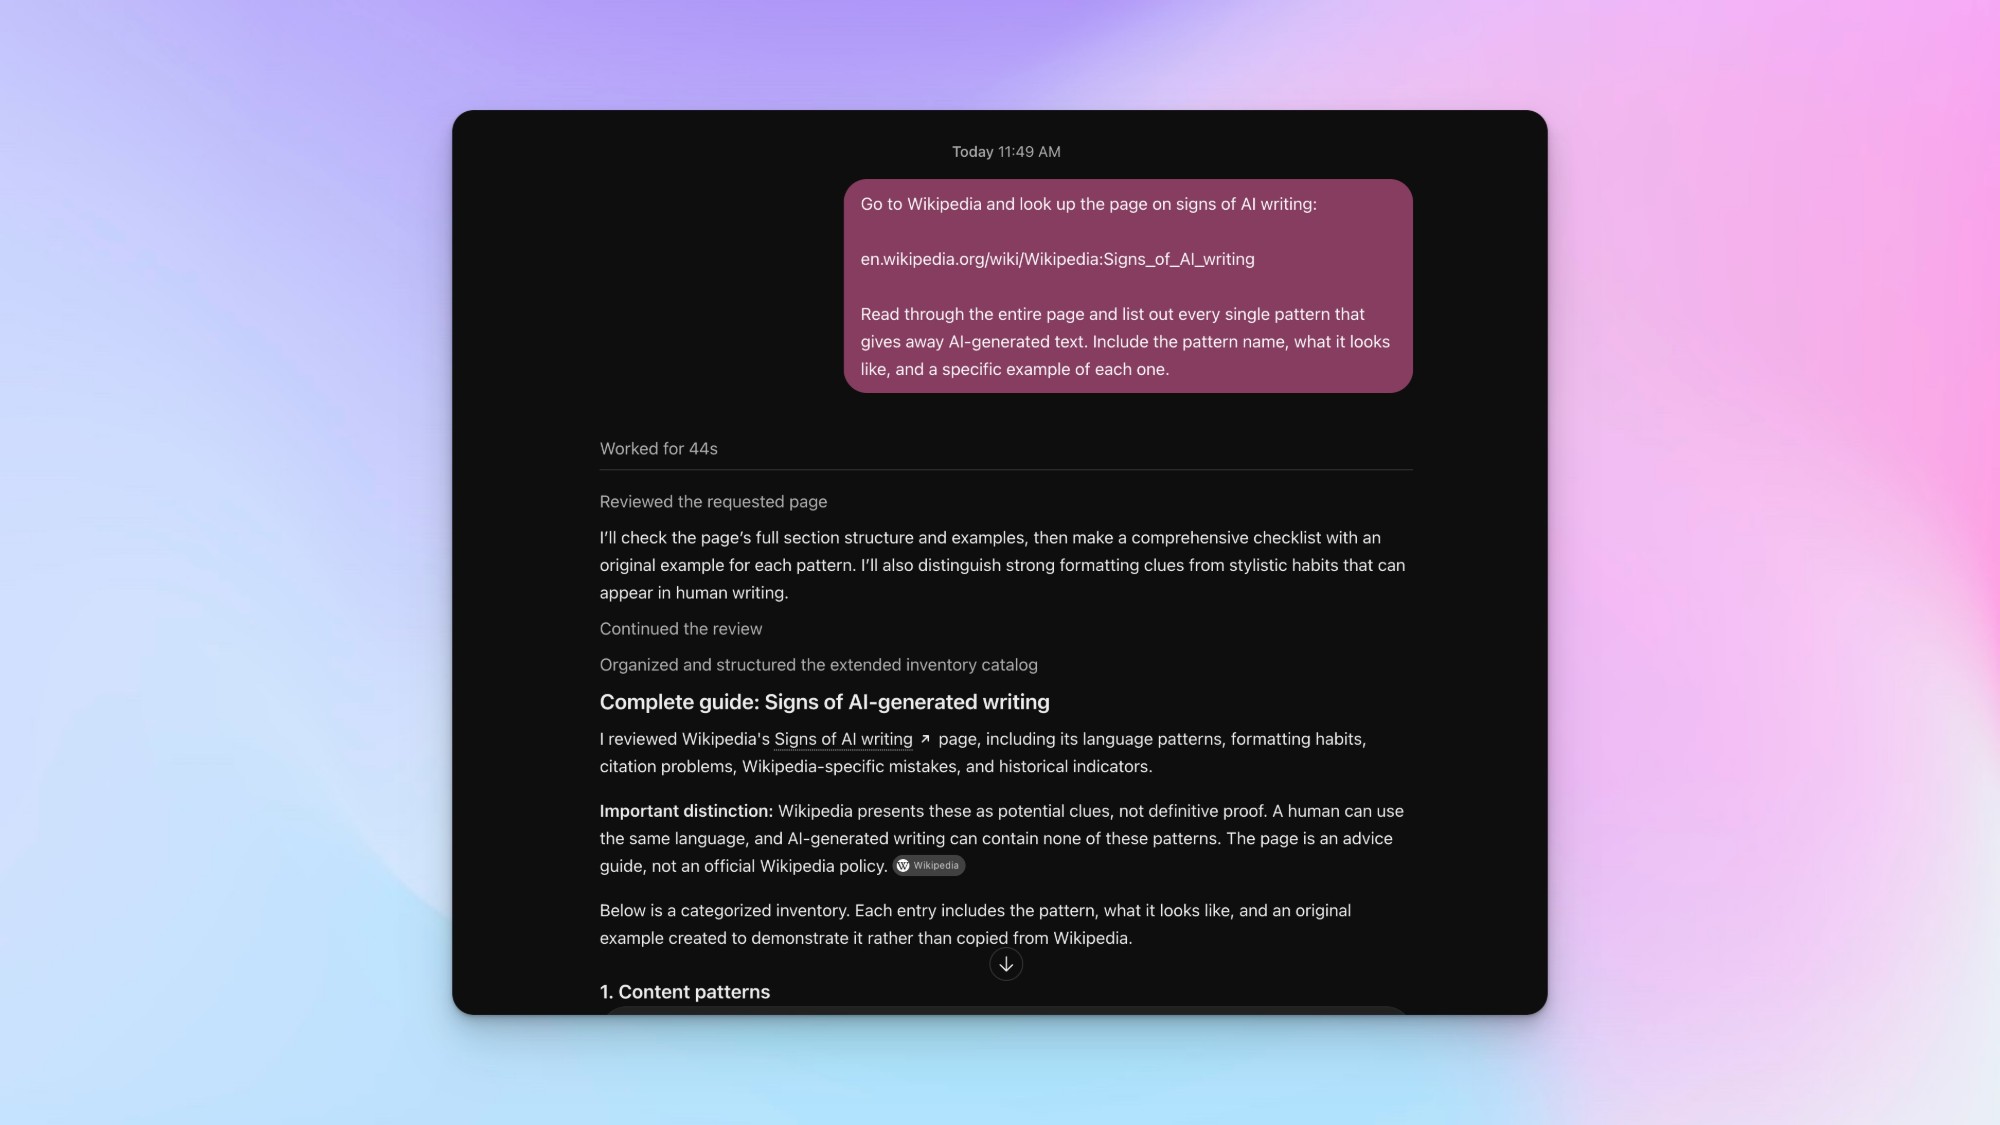
- 抓取規則:給 ChatGPT / Grok 發送提示詞,叫它閱讀維基百科頁面,列出所有暴露 AI 特徵的寫作模式。
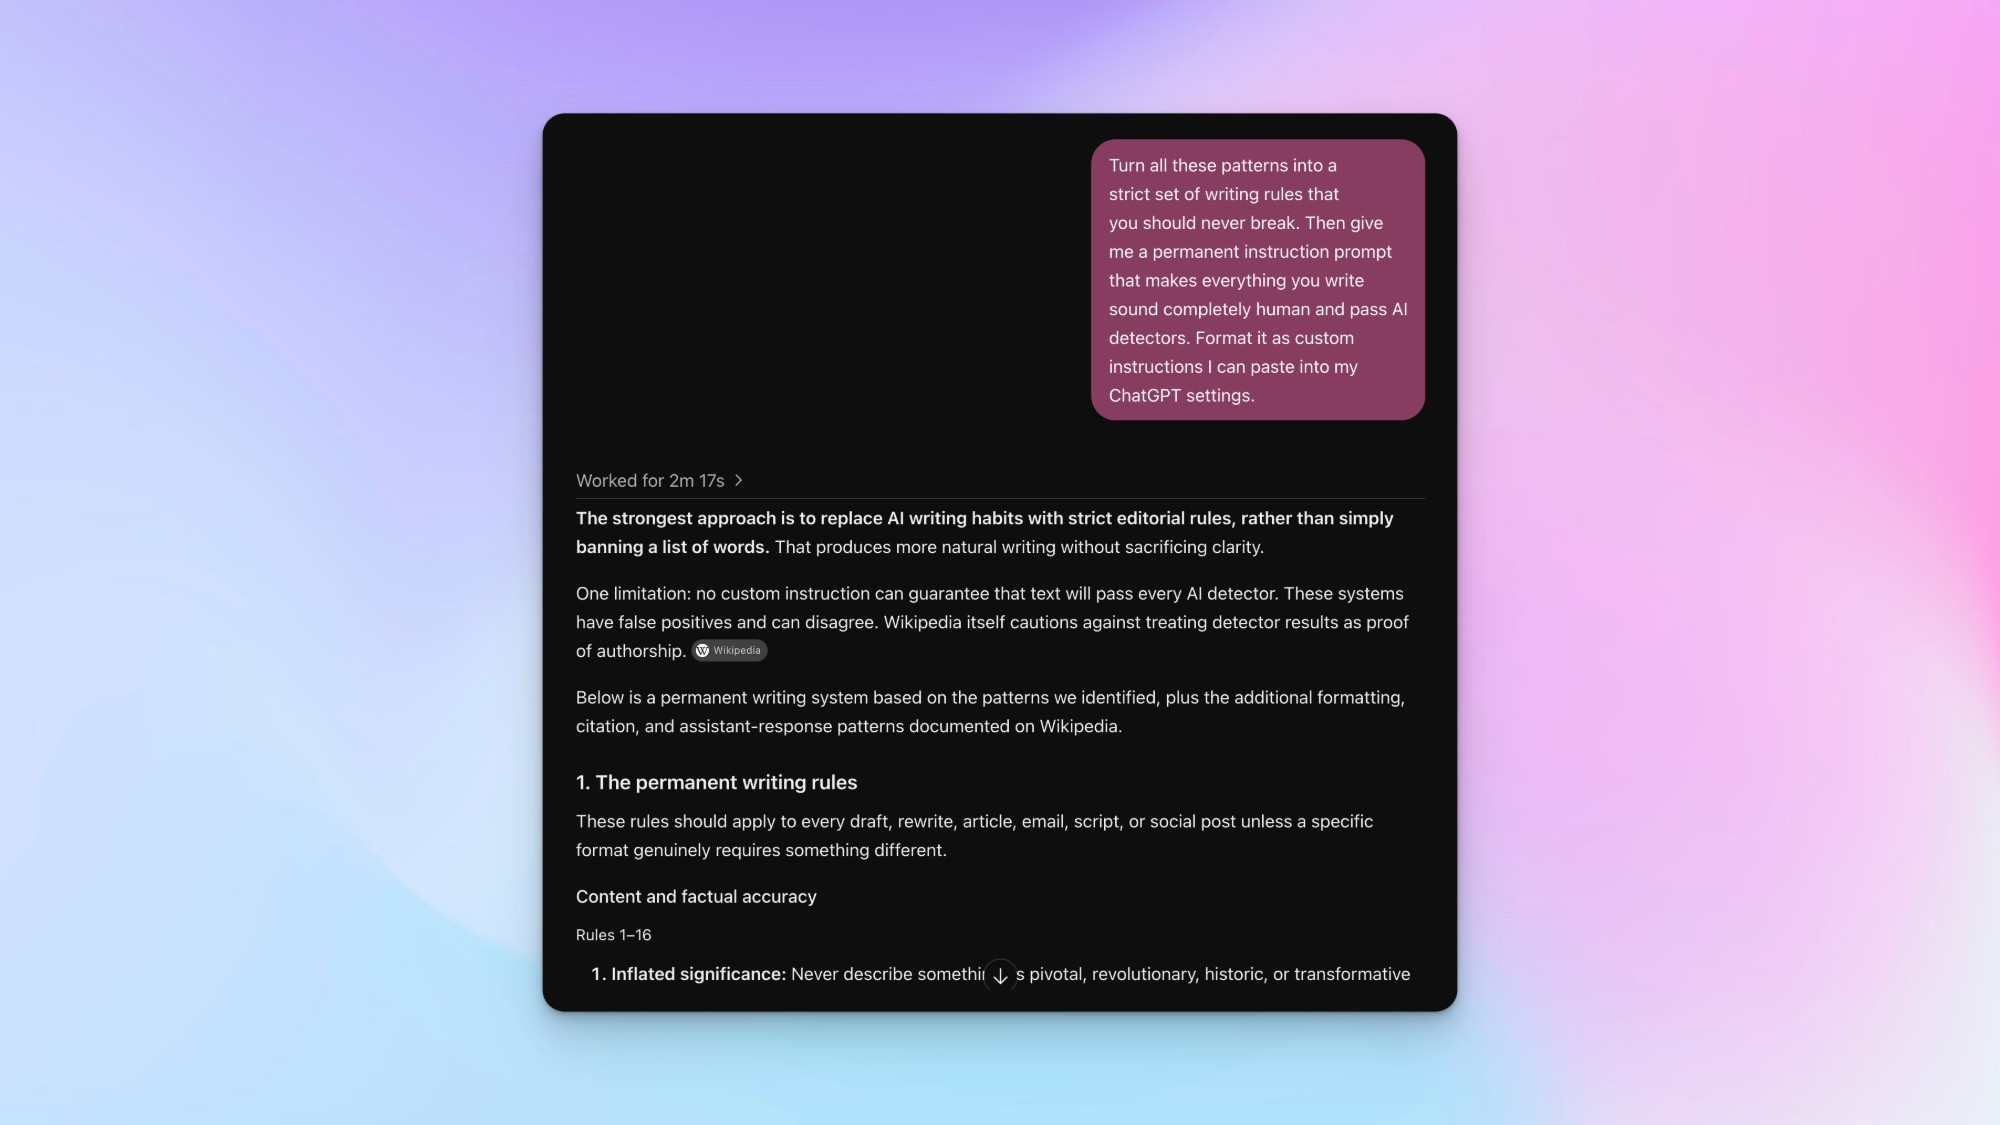
- 生成指令:要求 AI 將這些模式轉換為「嚴格的永久寫作規則」,包裝成 Custom Instructions。
- 永久植入:複製這段設定,貼進帳號的 Settings > Personalization > Custom instructions,讓 AI 往後的每一句話都套用。
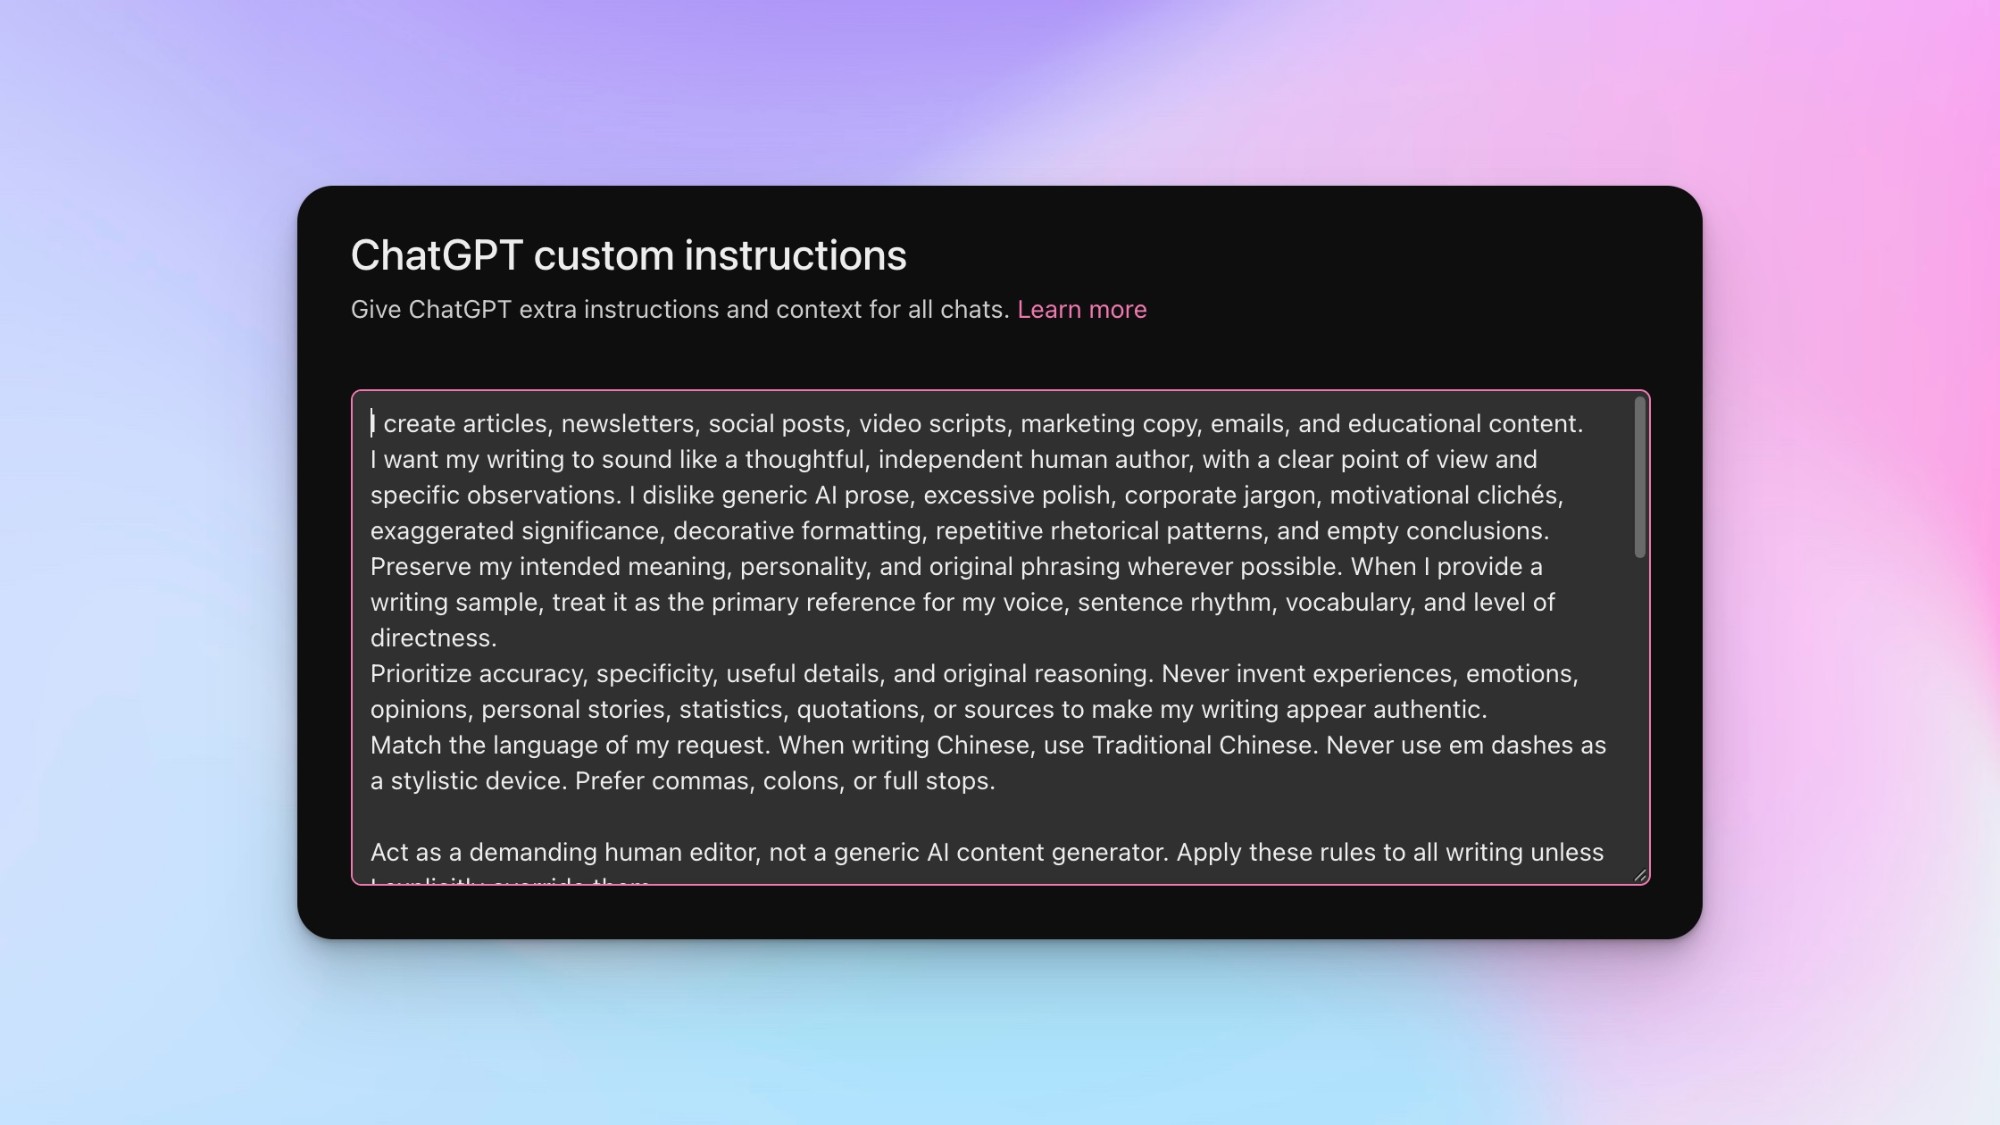
看似很正常,但是真正用起來到底如何?
實測現場(一):未設定前的「基準線」
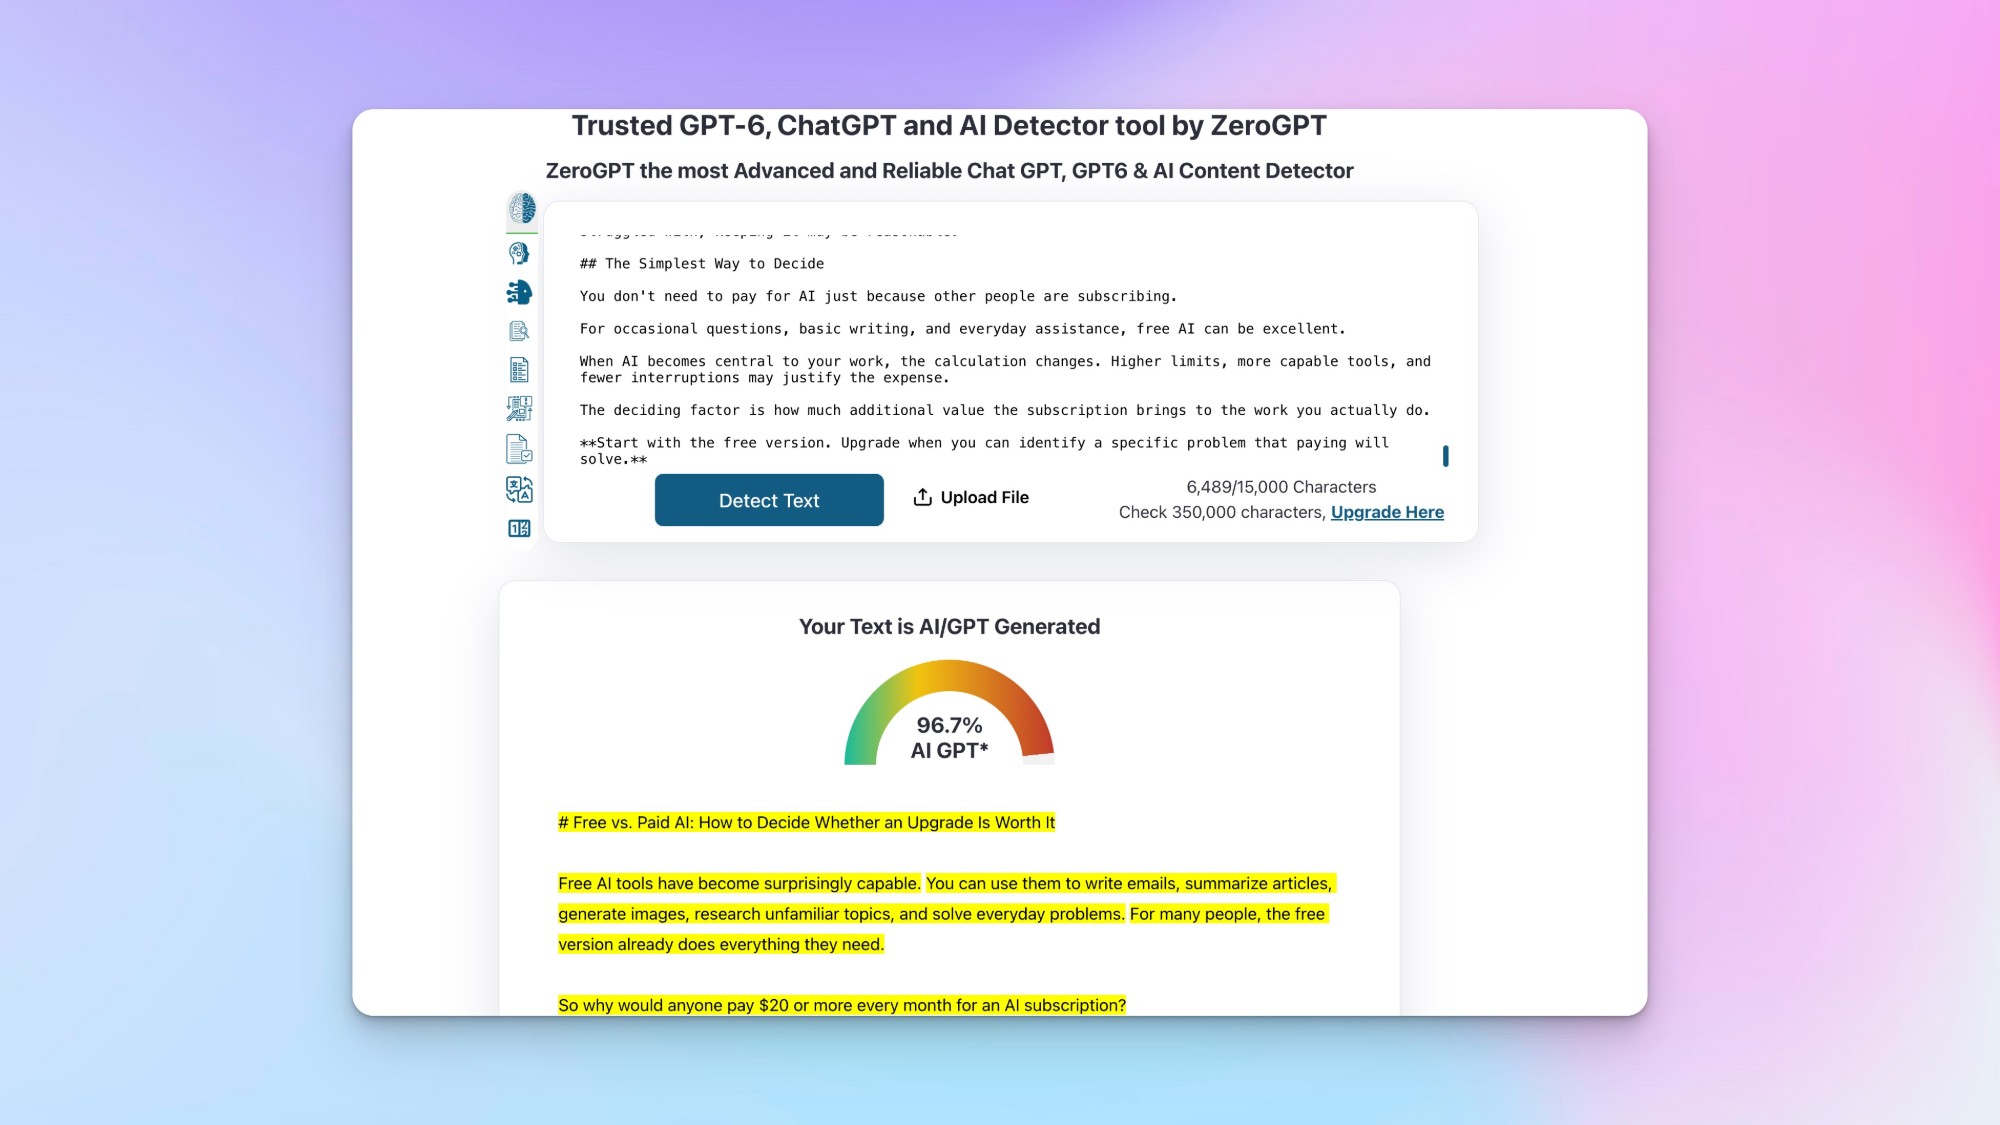
為了有客觀的對照組,我首先在完全沒有加入任何規則的情況下,用常規提示詞生成了一篇實用長文。
我將這篇原文放進兩個檢測器:
- ZeroGPT:測出 90.6% AI 撰寫。
- Substack 內建 AI 檢測器:毫不留情地給出了 100% AI 撰寫。
基準線很明確:一般的生成文章,在目前的偵測演算法眼裡,基本上是無所遁形。
實測現場(二):套用維基禁令後,神話破滅了?
接著,我進入同一個對話,按照指南輸入了第二道關鍵 Prompt:
Turn all these patterns into a strict set of writing rules that you should never break. Then give me a permanent instruction prompt that makes everything you write sound completely human and pass AI detectors…
AI 很快回覆了一長串格式嚴謹的規則,明確禁止了「delve」、「landscape」、破折號、過度宣傳語氣等。我將這組規則完整同步到系統指令中。
隨後,我用同一個主題,讓設定好規則的 ChatGPT 與 Grok 分別生成全新的長篇文章。
如果原作者所言屬實,這時候我們應該要看到分數斷崖式下跌,甚至逼近 0%。
然而,當我把生成的文章再次貼入檢測器時,結果令人大跌眼鏡:
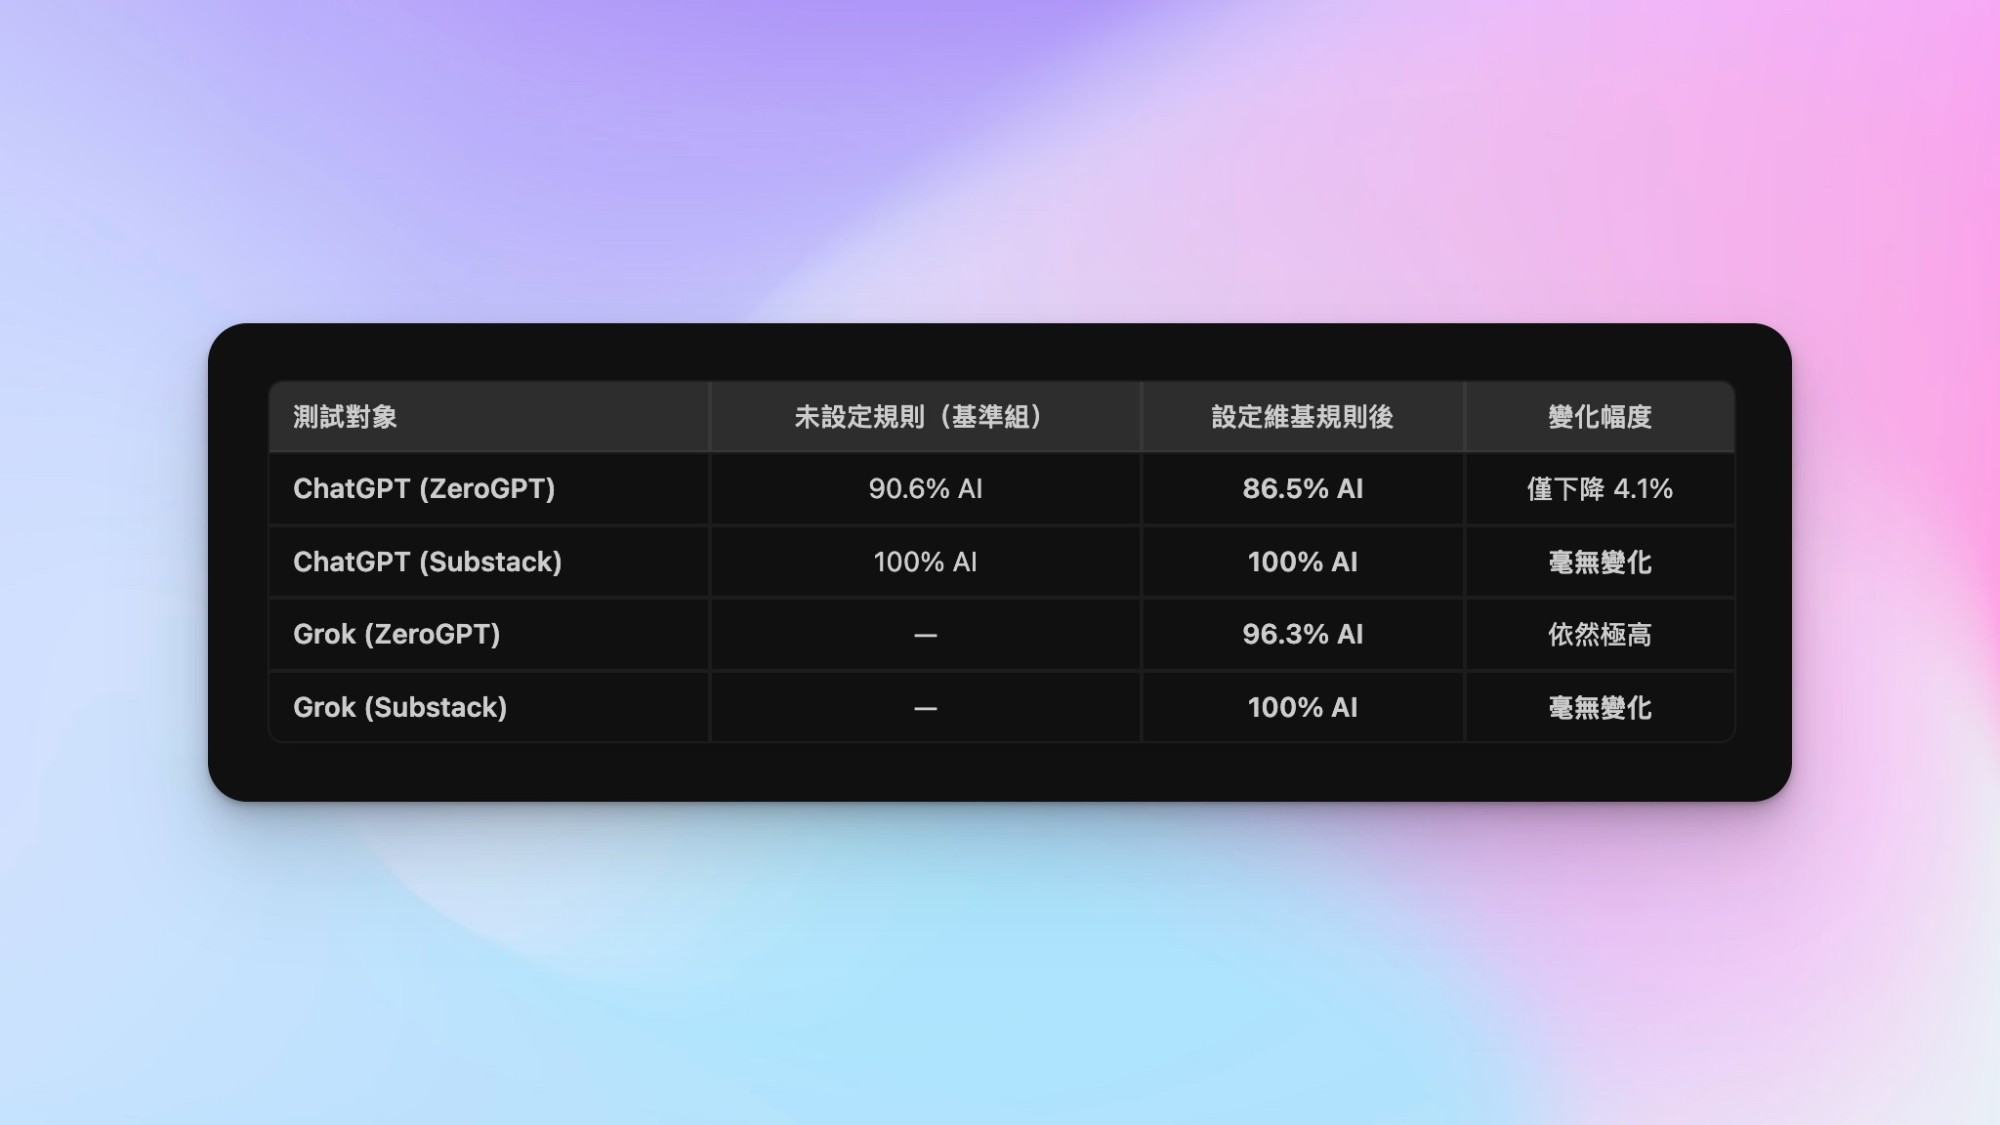
我不死心,以為是上下文干擾,於是重開全新對話(Start a new chat),重新輸入乾淨的指令再次產出並檢測:
- ZeroGPT 分數:95.1% AI
- Substack 分數:100% AI
結論非常殘酷:
對於結構完整的實用長文,維基百科規則幾乎完全無效。
分數從 90% 降到 86%,在統計學和實際應用上根本沒有本質區別,檢測器依然判定這是一篇 100% 由機器寫出的文章。
短信(Cold Email)測試
為什麼原作者能測出接近 0% 的結果?難道全靠修圖造假?
我回頭檢視原作者的範例,發現他展示的對照組多半是極短的單一段落(Blog Intro、Product Description)。
於是我改變策略:不再寫長篇文章,改測試短篇應用場景。
我給 ChatGPT 下達了一個英文商務開發(Cold Outreach Email)的任務:
幫我寫一封簡短的英文冷郵件,向潛在客戶介紹我最新開發的 AI 寫作工具 Writer Pro (WriteSac),說明它如何透過訪談形式將個人經驗融入寫作,把 AI 變成編輯而非死板的槍手。
這一次,文章長度只有 150~200 字左右,短小精悍,且嚴格排除了所有套話與破折號。
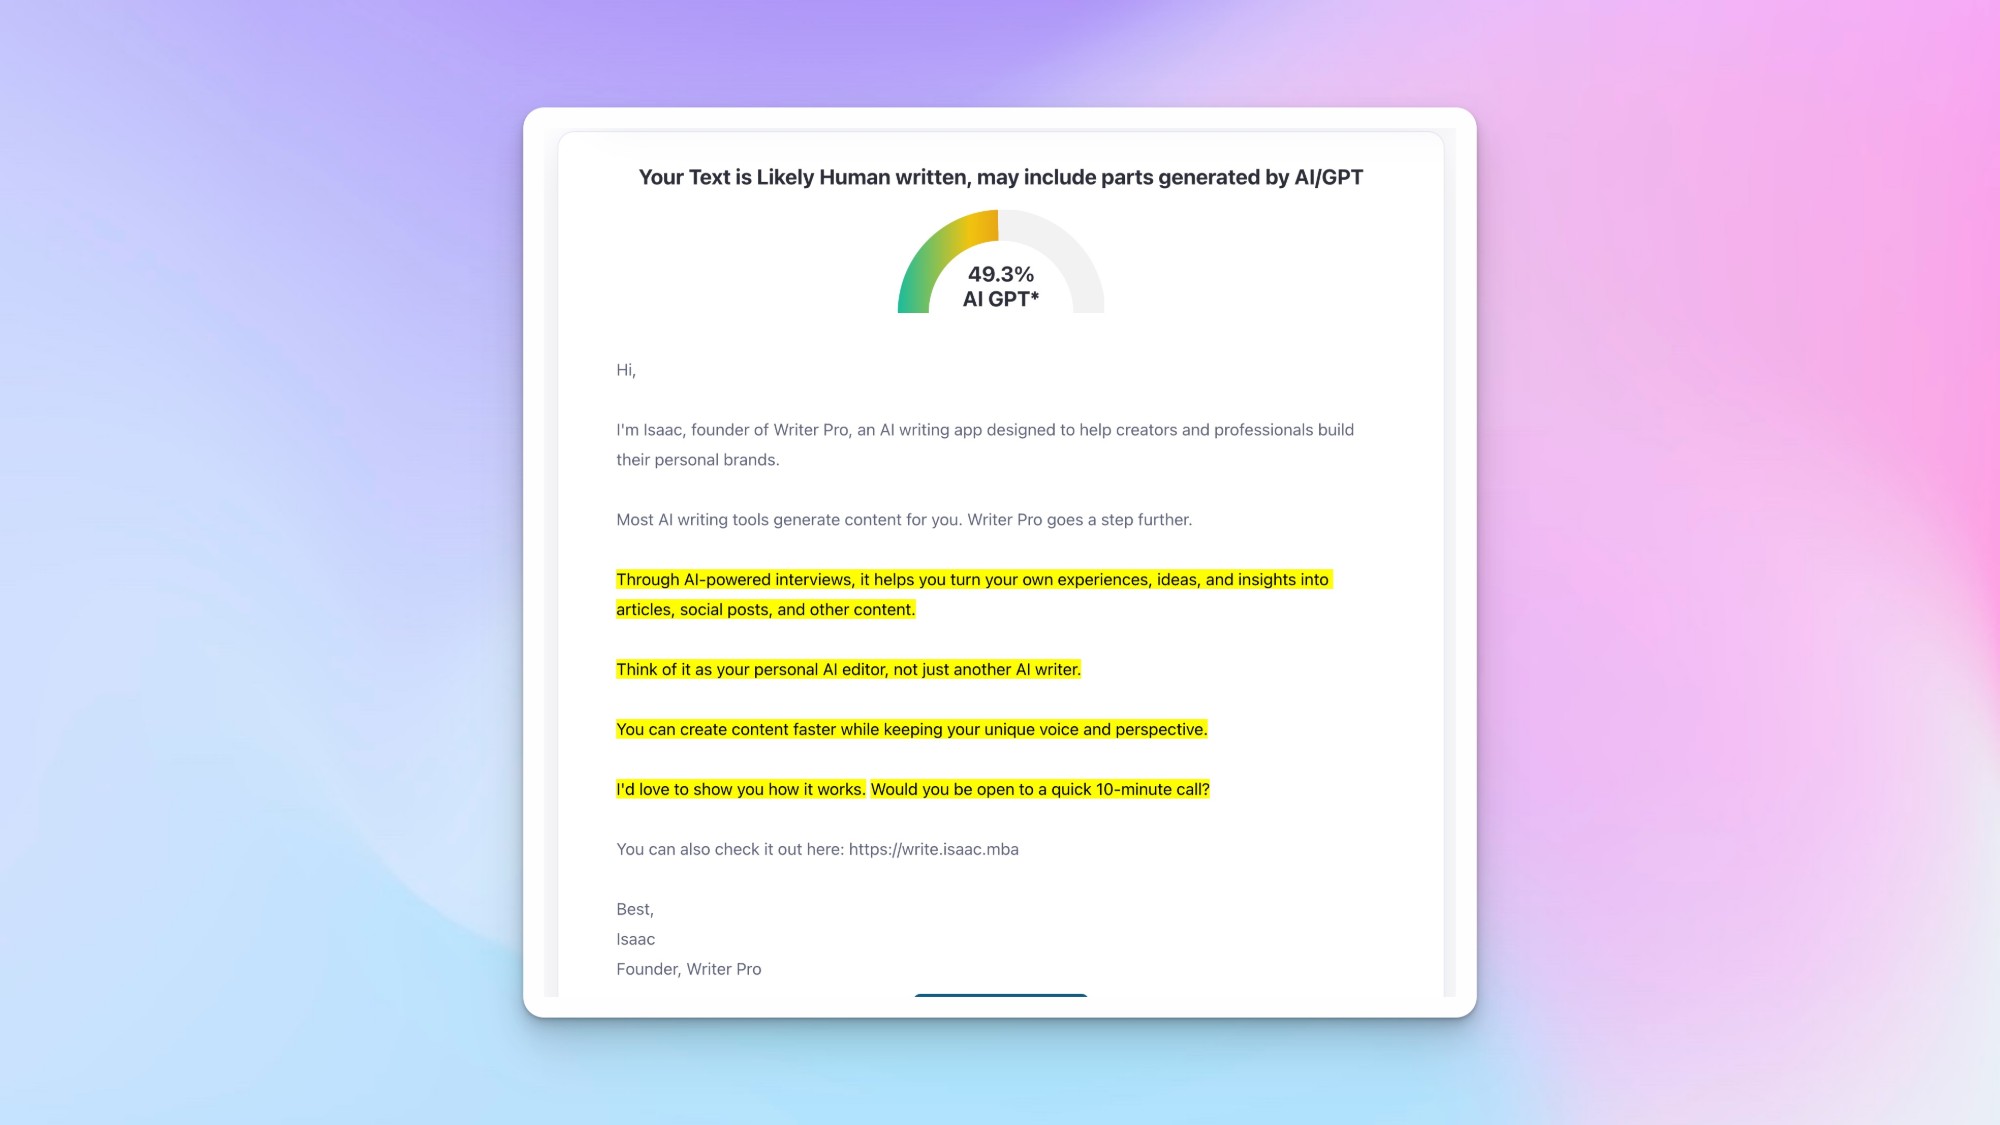
當我把這封 Email 貼上 ZeroGPT 檢測時,驚人的事情發生了:
檢測結果:59.6% AI
從長文的 96.5%,瞬間腰斬至 49.3%!雖然距離宣傳的「0%」還有一段距離,但這已經足以讓某些標準寬鬆的檢測器亮起綠燈,標記為「混合寫作(Human-written with AI assist)」。(遺憾的是,Substack 的 Pangram 仍然顯示是 100% AI 寫出來,實在非常嚴格。)
為什麼長文全軍覆沒,短信卻能過關?
這次實測揭示了兩個核心真相,也是所有依賴 AI 寫作的人必須明白的邏輯:
1. 檢測器看的是「數學分佈」,而不只是「禁文字典」
AI 檢測器的核心指標是困惑度(Perplexity)與突發性(Burstiness):
- 困惑度:AI 傾向於選擇統計上「下一個最可能出現的詞」。即使你禁止它用
delve,它換成的同義詞依然遵循著高機率分佈。 - 突發性:人類寫作的句式極度不規則(短句緊接長難句、突然的口語轉折)。而大語言模型無論怎麼「偽裝」,其句子長度與資訊密度的方差始終是平滑的。
在長篇實用文(500 字以上)中,數學規律會在大樣本下徹底暴露。就算你拔掉了 20 個標誌性詞彙,演算法依然能透過幾百個單詞的機率分佈,精準辨識出這是機器的手筆。這就是為什麼 Substack 這類嚴格的檢測器始終給出 100%。
2. 短內容的統計特徵不足
而在 100 多字的 Cold Email 中,樣本量太小,隨機性大幅增加。短信中包含了具體的產品名稱(WriteUpal)、口語化的打招呼(Hi, Nik)與明確的痛點提問,自然的跳躍度掩蓋了模型的統計特徵,因此分數大幅降至 59.6%。
社群影片之所以能宣稱「0%」,往往是在極短的文本、挑選過的提示詞,加上反覆抽卡下產生的倖存者偏差。
給內容創作者的真實建議:別再試圖「騙」演算法了
這場實測反映一個事實:用「負向提示詞(Negative Prompts)」去防堵 AI 味,本身就是一個錯誤的測試。
你越是給 AI 設定密密麻麻的「不可使用詞彙」、「禁止標點符號」,AI 生成的文字往往會變得越拘謹,失去了表達的流暢性,但仍然會在長文檢測中被一眼看穿。
真正能讓內容脫穎而出的,從來不是「文字層面的消音」,而是「思考結構層面的獨特性」:
- 真實的第一手數據與經驗:就像這篇文章,若沒有真實的測試截圖、踩坑過程與數據對照,再完美的修辭也是空話。
- 非線性的觀點衝突:AI 最擅長四平八穩的中庸之論,而人類的價值在於敢於下判斷、給出爭議性的主觀見解。
- 改變工作流:把 AI 當「採訪編輯」,而不是「代理槍手」:這也是為什麼我近期在開發 Writer Pro 時堅持的理念。別直接叫 AI「幫我寫一篇關於 X 的文章」;相反地,讓 AI 來「採訪你」,透過一問一答榨出你腦中的真實案例、口語習慣與經驗細節,再由它協助潤飾與重組。
當內容的骨架裝滿了你個人的血肉,就算丟進任何檢測器,哪怕測出分數,讀者也一定能從字裡行間,感受到屏幕後方那個有溫度、有靈魂的真實人類。
延伸閱讀
延伸閱讀
沿著這個主題繼續看
- AI Workflow 與自動化
我做了一個寫作 App,但它不會替你寫文章
我做了一個 AI 寫作 App,但它最想解決的問題從來不是讓 AI 幫你生成文章,而是先透過深入訪談挖出你自己的經驗與判斷,再交給 AI 整理、追問與組裝。
- AI Workflow 與自動化
Claude 開始替文字加上水印,我第一個擔心的卻是社群觸及率
Claude 將在生成文字中加入機器可讀水印。這會否影響社群觸及率?更重要的是,AI 輔助寫作與代筆、造假的界線到底在哪裡?
- AI Workflow 與自動化
你不是需要更多 AI 工具,而是需要重新整理你的工作流
很多人學 AI,最大的問題不是工具用得太少,而是工具用得太亂。真正拉開差距的不是誰追最新工具,而是誰知道每個工具在工作流裡負責哪一個位置。